Um dos problemas causados pelo aumento do tráfego telefônico é o esgotamento da capacidade dos recursos de interconexão entre centrais. Inicialmente esta interconexão era feita com cabos multipar, e nem sempre é possível, ou economicamente viável, lançar cabos adicionais ou substituir os cabos existentes para ampliar a capacidade. O exemplo mais comum disso são os cabos submarinos. Caro demais substituir ou lançar mais um cabo paralelo ao existente, então como aumentar a capacidade?
A saída é a multiplexação. Multiplexar é apenas outra forma de dizer compartilhar. A idéia é: em vez de limitar a utilização de um par de fios para um chamada de cada vez, vamos usar o mesmo par de fios (ou outros meios de transmissão) para várias chamadas simultâneas.
Aqui temos que fazer um parêntese matemático. Nada muito complicado, e nenhuma conta pra fazer. Appenas o entendimento de alguns conceitos. Mas se você não entender isto aqui, muita coisa mais tarde vai parecer bruxaria.
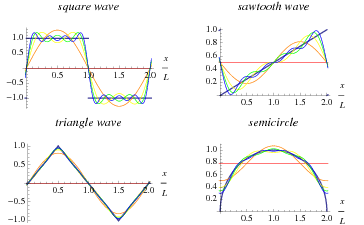
O sinal elétrico analógico (tensão ou corrente) que representa a voz do usuário participante de uma chamada telefônica pode ser descrito como uma função do tempo. Em 1807 Joseph Fourier demonstrou que qualquer função pode ser decomposta na forma de uma série infinita de funções seno e cosseno (isto também pode ser visto como funções exponenciais complexas, mas deixa isso pra lá...). Este tipo de série foi batizada série de Fourier, em sua homenagem. A figura abaixo dá alguns exemplos (parciais) da decomposição de algumas funções em série de Fourier.
Com isto temos uma forma alternativa para representar funções no tempo. Podemos representá-las através da amplitude de cada um dos termos da sua decomposição em série de Fourier. Ou seja: uma função tensão (ou corrente) x tempo pode ser expressa por uma função equivalente amplitude x frequência. Exemplo: a figura abaixo é o gráfico de um sinal elétrico em função do tempo medido na saída de um microfone (repare que a tensão é proporcional à pressão do ar gerada pelas ondas sonoras captadas pelo microfone).
Quando obtemos a sua decomposição em série de Fourier, através de um processo chamado de transformada de Fourier, obtemos o seguinte gráfico de amplitude em função da frequência.
Então observamos que o nosso sinal originl é possui apenas duas componentes, uma com frequência de 4 Hz e amplitude 1 V (no caso) e outra com frequência de 12 Hz e amplitude aproximada de 0,3 V. O primeiro gráfico é conhecido como a representação do sinal no domínio tempo, e o segundo como a representação do sinal no domínio frequência. O segundo gráfico também é conhecido como o espectro de frequências do sinal representado no primeiro gráfico. Fim do parêntese (outros virão mais tarde).
Suponha agora que nós temos um sinal arbitrário s(t) cuja rpresentação no domínio frequência seja algo parecido com a figura abaixo.
A conversão entre a frequência f (expressa em Hertz) e a frequência angular w (ômega minúsculo, expressa em radianos/segundo) é dada pela fórmula:
Agora vamos considerar um sinal C(t), puramente senoidal, que, só por conveniência, vamos representar por uma função cosseno. Vamos tomar a nossa origem no temo de tal forma que a fase deste sinal seja igual a zero. Então, no domínio frequência, temos o seguinte:
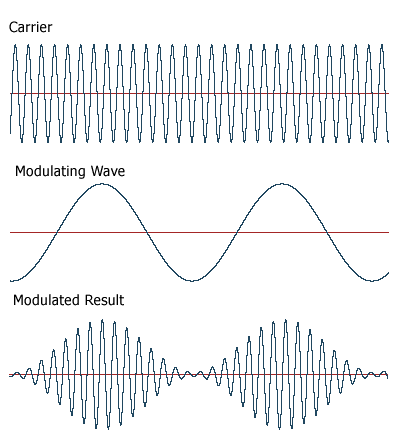
Vamos agora fazer que a amplitude do sinal C(t) (portadora ou carrier) varie em função do sinal s(t). Desta forma obtemos um sinal modulado em amplitude (amplitude modulated ou AM). No domínio tempo temos algo parecido com o mostrado na figura abaixo (onde s(t) é um sinal senoidal puro)
O nosso sinal AM tem a seguinte aparência no domínio frequência:
Reparem que o nosso sinal original teve seu espectro de frequência trasladado da origem para a frequência da portadora. Então podemos fazer o seguinte esquema:
Este é o auge da tecnologia analógica para a transmissão de sinais entre as centrais de comutação. FDM significa frequency division multiplexing, e como pode ser visto na figura, a multiplexação é feita pela modulação AM dos vários sinais de entrada, cada um deles modulando portadoras separadas em frequência de tal forma que os espectros individuais não se sobreponham após a translação. Na outra ponta do circuito cada sinal individual pode ser separado do sinal multiplexado M(t) usando filtros passa-faixa centrados na frequência de cada portadora.
Daqui em diante os avanços tecnológicos ocorreram na digitalização da comutação e da transmissão de sinais entre as centrais de comutação. Trataremos disto na parte 2 deste artigo.
Comentários e artigos sobre telecomunicações, TI, tecnologia em geral ou qualquer outra coisa que me chame a atenção no momento.
Quem sou eu
- J. R. Smolka
- Salvador, BA, Brazil
- Analista de sistemas, expert em telecom, formado em Eng. Elétrica e nerd assumido
domingo, 31 de julho de 2011
sábado, 30 de julho de 2011
Redes de telecomunicação (1) - Os primórdios
Pessoal, tenho observado que muita gente boa que atua na área de telecom tem uma estranha deficiência de entendimento quanto ao que são, como funcionavam, como funcionam e como funcionarão as redes de telecomunicação. Para dar uma ajudinha a este povo que acha que quem ferve a 90 graus é o ângulo reto, decidi iniciar esta série de artigos.
Vamos começar pela evolução da "mãe de todas as redes": a rede telefônica.
Depois que Alexander Graham Bell inventou o telefone, os construtores de redes telefônicas como um negócio notaram que não era prático conectar todos os usuários entre si, porque o número de enlaces necessários cresce muito rápido à medida que o número de nós conectados aumenta.
Já que uma topologia totalmente ligada (full mesh) não é viável economicamente, a alternativa natural foi recorrer a uma topologia estrela (hub and spokes).
Neste caso, o nó central da rede, chamado nó de comutação (exchange node), utilizava um painel de conexões (switchboard), e as conexões eram completadas ligando os pares de usuários via cabos de interconexão (patch cables). Lembrem-se de que ainda estamos falando dos primórdios da rede telefônica.
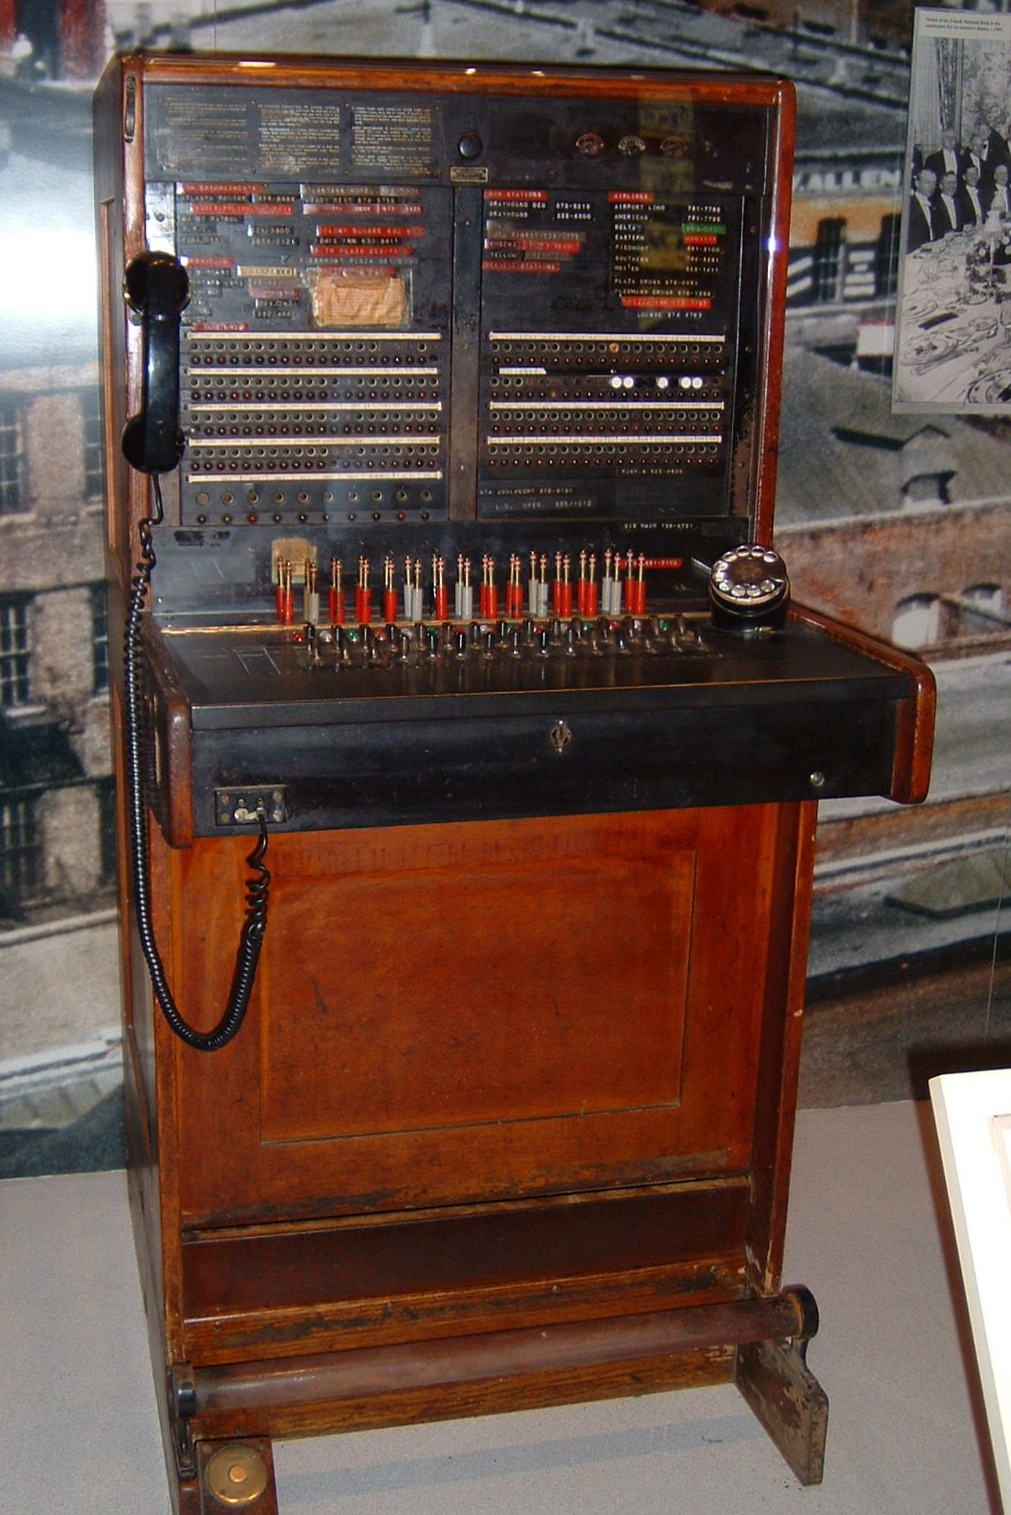
A fotografia abaixo mostra um modelo de switchboard fabricado em 1924.
Mas isso só adiantou por pouco tempo. Com o crescimento do número de usuários do serviço telefônico, bem como seu espalhamento geográfico, as operadoras rapidamente tiveram que adotar uma hierarquia de switchboards, os locais, responsáveis pela conexão entre um grupo geograficamente restrito de usuários, e os de trânsito (tandem), responsáveis pela conexão entre grupos locais.
Neste ponto da história entra em cena Agner Krarup Erlang, engenheiro, matemático e estatístico dinamarquês. Com seus livros A Teoria das Probabilidades e as Conversações Telefônicas (1908) e Solução de Alguns Problemas da Teoria das Probabilidades Significativos Para as Centrais Telefônicas Automáticas (1917) ele foi o pioneiro no estudo da teoria do tráfego telefônico e da teoria das filas, usadas como ferramentas para o dimensionamento racional da rede. Antigamente o uso das fórmulas de Erlang era simplificado pelo uso de tabelas padronizadas. Hoje existem sites e softwares para efetuar o cálculo das fórmulas quando necessário.
O elemento principal que permitiu o desenvolvimento de centrais telefônicas automáticas foi a invenção do relé de passo (ou relé Strowger) por Almon Brown Strowger em 1891. Eles são o bloco básico de construção das chamadass centrais de passo ou centrais Strowger (step-by step exchange ou stepper exchange).
As centrais automáticas substituiram inicialmente as telefonistas que operavam os switchboards locais, e, mais tarde, também as telefonistas dos switchboards de trânsito. Mantendo a nomenclatura, elas passaram a ser denominadas centrais locais ou centrais de trânsito (tandem) conforme a sua forma de atuar no estabelecimento das chamadas (call setup).
Outra novidade com a introdução de centrais automáticas foi o surgimento de protocolos de sinalização central-assinante e central-central.
A sinalização central-assinante envolve a geração automática de sons pela central para indicar a disponibilidade para receber informação do usuário (tom de discar - dial tone), o início do toque da campainha no destino (tom de chamada - ringback tone), a indisponibilidade do destino para receber a chamada (tom de ocupado - busy tone), e a ocorrência de erros no encaminhamento da chamada (tom de erro - reorder tone).
A primeira forma de sinalização assinante-central foi a sinalização decádica, feita com o uso de um disco rotatório que gera trens de pulsos elétricos para representar os dígitos de 0 a 9 (um pulso = dígito 1, dois pulsos = dígito 2, ... , nove pulsos = dígito 9, dez pulsos = dígito 0). Posteriormente a sinalização central-assinante e assinante-central foram padronizadas na sinalização DTMF (Dual-Tone Multi-Frequency). Para os dígitos da sinalização assinante-central o padrão internacional é definido na recomendação Q.23 da ITU-T. Cada dígito corresponde à geração simultânea de dois tons, conforme a tabela abaixo.
A sinalização central-assinante está aberta para padronização local em cada país. O padrão adotado nos Estados Unidos é:
A tecnologia de construção das centrais evoluiu para as centrais de painel (panel switches) e centrais crossbar. Depois disso começou a onda da digitalização da rede. Mas isto já é assunto para o próximo artigo desta série.
Vamos começar pela evolução da "mãe de todas as redes": a rede telefônica.
Depois que Alexander Graham Bell inventou o telefone, os construtores de redes telefônicas como um negócio notaram que não era prático conectar todos os usuários entre si, porque o número de enlaces necessários cresce muito rápido à medida que o número de nós conectados aumenta.
Já que uma topologia totalmente ligada (full mesh) não é viável economicamente, a alternativa natural foi recorrer a uma topologia estrela (hub and spokes).
Neste caso, o nó central da rede, chamado nó de comutação (exchange node), utilizava um painel de conexões (switchboard), e as conexões eram completadas ligando os pares de usuários via cabos de interconexão (patch cables). Lembrem-se de que ainda estamos falando dos primórdios da rede telefônica.
A fotografia abaixo mostra um modelo de switchboard fabricado em 1924.
Mas isso só adiantou por pouco tempo. Com o crescimento do número de usuários do serviço telefônico, bem como seu espalhamento geográfico, as operadoras rapidamente tiveram que adotar uma hierarquia de switchboards, os locais, responsáveis pela conexão entre um grupo geograficamente restrito de usuários, e os de trânsito (tandem), responsáveis pela conexão entre grupos locais.
Neste ponto da história entra em cena Agner Krarup Erlang, engenheiro, matemático e estatístico dinamarquês. Com seus livros A Teoria das Probabilidades e as Conversações Telefônicas (1908) e Solução de Alguns Problemas da Teoria das Probabilidades Significativos Para as Centrais Telefônicas Automáticas (1917) ele foi o pioneiro no estudo da teoria do tráfego telefônico e da teoria das filas, usadas como ferramentas para o dimensionamento racional da rede. Antigamente o uso das fórmulas de Erlang era simplificado pelo uso de tabelas padronizadas. Hoje existem sites e softwares para efetuar o cálculo das fórmulas quando necessário.
O elemento principal que permitiu o desenvolvimento de centrais telefônicas automáticas foi a invenção do relé de passo (ou relé Strowger) por Almon Brown Strowger em 1891. Eles são o bloco básico de construção das chamadass centrais de passo ou centrais Strowger (step-by step exchange ou stepper exchange).
As centrais automáticas substituiram inicialmente as telefonistas que operavam os switchboards locais, e, mais tarde, também as telefonistas dos switchboards de trânsito. Mantendo a nomenclatura, elas passaram a ser denominadas centrais locais ou centrais de trânsito (tandem) conforme a sua forma de atuar no estabelecimento das chamadas (call setup).
Outra novidade com a introdução de centrais automáticas foi o surgimento de protocolos de sinalização central-assinante e central-central.
A sinalização central-assinante envolve a geração automática de sons pela central para indicar a disponibilidade para receber informação do usuário (tom de discar - dial tone), o início do toque da campainha no destino (tom de chamada - ringback tone), a indisponibilidade do destino para receber a chamada (tom de ocupado - busy tone), e a ocorrência de erros no encaminhamento da chamada (tom de erro - reorder tone).
A primeira forma de sinalização assinante-central foi a sinalização decádica, feita com o uso de um disco rotatório que gera trens de pulsos elétricos para representar os dígitos de 0 a 9 (um pulso = dígito 1, dois pulsos = dígito 2, ... , nove pulsos = dígito 9, dez pulsos = dígito 0). Posteriormente a sinalização central-assinante e assinante-central foram padronizadas na sinalização DTMF (Dual-Tone Multi-Frequency). Para os dígitos da sinalização assinante-central o padrão internacional é definido na recomendação Q.23 da ITU-T. Cada dígito corresponde à geração simultânea de dois tons, conforme a tabela abaixo.
A sinalização central-assinante está aberta para padronização local em cada país. O padrão adotado nos Estados Unidos é:
- Tom de discar - 350 Hz + 440 Hz, -13 dBm, contínuo;
- Tom de chamada - 440 Hz + 480 Hz, -19 dBm, intermitente (duração de 2 segundos e intervalo de 4 segundos);
- Tom de ocupado - 480 Hz + 620 Hz, -24 dBm, intermitente (duração de 0,5 segundos e intervalo de 0,5 segundos);
- Tom de erro - 480 Hz + 620 Hz, -24 dBm, intermitente (duração de 0,25 segundos e intervalo de 0,25 segundos)
A tecnologia de construção das centrais evoluiu para as centrais de painel (panel switches) e centrais crossbar. Depois disso começou a onda da digitalização da rede. Mas isto já é assunto para o próximo artigo desta série.
terça-feira, 12 de julho de 2011
Controle Estatístico de Processos
No segundo post sobre disponibilidade eu mencionei, assim meio que de passagem, que a forma correta de avaliar a capacidade de uma determinada topologia do edge site para cumprir as exigências de disponibilidade era usar as estatísticas reais, ou pelo menos aproximadas em laboratório, dos tempos de reconvergência das rotas após algum evento.
Isto nos leva à pergunta: como fazer para, usando as estatísticas de comportamento de algum processo, garantir que ele consiga, consistentemente, produzir resultados de acordo com o esperado?
A resposta para esta pergunta começa pelo reconhecimento que, inevitavelmente, qualquer processo sempre apresenta alguma variabilidade nos seus resultados. O primeiro segredo do negócio é reconhecer se a forma como esta variabilidade está ocorrendo, na prática, é puramente aleatória (o que é natural e esperado) ou se existem fatores externos influenciando e introduzindo tendências anormais de variablidade nos resultados. Chamamos de causas naturais de variabilidade aquelas que são inerentes à natureza do processo, enquanto os fatores externos de variablidade são chamados causas especiais.
Não vou me alongar sobre como reconhecer se existem causas especiais para a variabilidade exibida pelos resultados do processo (dica: estudem o trabalho de Walter Shewhart). Entretanto não existe possibilidade de controle estatístico do processo enquanto este tipo de causa de variabilidade existir no processo. Elas tem que ser devidamente identificadas e bloqueadas (dica: use o MASP). A partir do ponto onde existem somente as causas naturais para a variabilidade do resultado do processo, então podemos seguir adiante.
A questão agora é: qual é o comportamento da distribuição de frequência dos resultados do processo? Existem várias possibilidades, a depender da natureza do processo em estudo, mas vou explicar aqui o caso mais simples, onde o processa apresenta uma variabilidade com distribuição de frequência normal, ou gaussiana. Neste caso a variável (ou variáveis) medidas como resultado do processo tem um gráfico da sua distribuição de frequência na forma abaixo.
Em um distribuição deste tipo existem dois valores importantes: o valor médio da variável cuja frequência foi medida, normalmente representado pela letra x encimada por um traço (x barra), e o desvio padrão da distribuição, representado pela letra grega sigma minúscula.
O valor de x barra representa o valor mais frequente apresentado pela variável do resultado do processo que estamos estudando, e o valor do desvio padrão indica o grau de dispersão dos resultados observados em torno do valor médio. Quanto maior o valor de sigma mais "achatada" é a forma da curva da distribuição de frequências, e quanto menor o valor de sigma mais "pontuda" é a forma da curva da distribuição de frequências, conforme exemplo abaixo.
Outro fator importante a observar é a probabilidade de ocorrência de um determinado resultado para a variável medida. Podemos associar esta probabilidade com o número de desvios padrão de afastamento entre o valor procurado e o valor médio. Observe a figura abaixo.
Vemos que existe 0,13% de probabilidade de ocorrência de um valor que seja menor que x barra menos três sigmas, assim como também existe 0,13% de probabilidade de ocorrência de um valor que seja maior que x barra menos três sigmas. No geral dizemos que existe probabilidade de 0,26% de ocorrência de um valor que esteja mais afastado do valor médio que três desvios padrão, para mais ou para menos. Ou, inversamente, existe 99,84% de probabilidade de um resultado qualquer observado encontrar-se na faixa definida pelo valor médio mais ou menos três desvios padrão.
Próximo passo: identificar quais são os limites aceitáveis, de acordo com os requisitos do processo, para o valor da nossa variável medida. Estes limites de tolerância podem ser especificados como uma faixa de valores aceitáveis (ex.: diâmetro de 5 mm mais ou menos 0,01 mm) ou como um único valor limite que não deve ser excedido, para mais ou para menos (ex.: tempo de resposta não superior a 3 segundos, temperatura não inferior a 20 °C). O segredo para ter nosso processo sob controle estatístico é garantir que a sua faixa de variablidade de, por exemplo, mais ou menos três desvios padrão em torno do valor médio, caiba inteiramente dentro da faixa de valores de tolerância para a variável do processo que está sendo avaliada.
Ou, expressando algebicamente, o que queremos é que seja satisfeito o seguinte sistema de inequações:
Em que LST significa limite superior de tolerância, e LIT significa limite inferior de tolerância. Obviamente, se os requisitos do processo para a nossa variável for do tipo "não superior a..." ou "não inferior a...", então somente uma das equações acima deverá ser satisfeita.
O resultado disto é que podemos afirmar que existe 99,8% de probabilidade do resultado do nosso processo estar em conformidade com os requisitos. Porém, apesar disso parecer genial (e é...), existem algumas outras coisinhas com as quais se preocupar:
Isto nos leva à pergunta: como fazer para, usando as estatísticas de comportamento de algum processo, garantir que ele consiga, consistentemente, produzir resultados de acordo com o esperado?
A resposta para esta pergunta começa pelo reconhecimento que, inevitavelmente, qualquer processo sempre apresenta alguma variabilidade nos seus resultados. O primeiro segredo do negócio é reconhecer se a forma como esta variabilidade está ocorrendo, na prática, é puramente aleatória (o que é natural e esperado) ou se existem fatores externos influenciando e introduzindo tendências anormais de variablidade nos resultados. Chamamos de causas naturais de variabilidade aquelas que são inerentes à natureza do processo, enquanto os fatores externos de variablidade são chamados causas especiais.
Não vou me alongar sobre como reconhecer se existem causas especiais para a variabilidade exibida pelos resultados do processo (dica: estudem o trabalho de Walter Shewhart). Entretanto não existe possibilidade de controle estatístico do processo enquanto este tipo de causa de variabilidade existir no processo. Elas tem que ser devidamente identificadas e bloqueadas (dica: use o MASP). A partir do ponto onde existem somente as causas naturais para a variabilidade do resultado do processo, então podemos seguir adiante.
A questão agora é: qual é o comportamento da distribuição de frequência dos resultados do processo? Existem várias possibilidades, a depender da natureza do processo em estudo, mas vou explicar aqui o caso mais simples, onde o processa apresenta uma variabilidade com distribuição de frequência normal, ou gaussiana. Neste caso a variável (ou variáveis) medidas como resultado do processo tem um gráfico da sua distribuição de frequência na forma abaixo.
Em um distribuição deste tipo existem dois valores importantes: o valor médio da variável cuja frequência foi medida, normalmente representado pela letra x encimada por um traço (x barra), e o desvio padrão da distribuição, representado pela letra grega sigma minúscula.
O valor de x barra representa o valor mais frequente apresentado pela variável do resultado do processo que estamos estudando, e o valor do desvio padrão indica o grau de dispersão dos resultados observados em torno do valor médio. Quanto maior o valor de sigma mais "achatada" é a forma da curva da distribuição de frequências, e quanto menor o valor de sigma mais "pontuda" é a forma da curva da distribuição de frequências, conforme exemplo abaixo.
Outro fator importante a observar é a probabilidade de ocorrência de um determinado resultado para a variável medida. Podemos associar esta probabilidade com o número de desvios padrão de afastamento entre o valor procurado e o valor médio. Observe a figura abaixo.
Vemos que existe 0,13% de probabilidade de ocorrência de um valor que seja menor que x barra menos três sigmas, assim como também existe 0,13% de probabilidade de ocorrência de um valor que seja maior que x barra menos três sigmas. No geral dizemos que existe probabilidade de 0,26% de ocorrência de um valor que esteja mais afastado do valor médio que três desvios padrão, para mais ou para menos. Ou, inversamente, existe 99,84% de probabilidade de um resultado qualquer observado encontrar-se na faixa definida pelo valor médio mais ou menos três desvios padrão.
Próximo passo: identificar quais são os limites aceitáveis, de acordo com os requisitos do processo, para o valor da nossa variável medida. Estes limites de tolerância podem ser especificados como uma faixa de valores aceitáveis (ex.: diâmetro de 5 mm mais ou menos 0,01 mm) ou como um único valor limite que não deve ser excedido, para mais ou para menos (ex.: tempo de resposta não superior a 3 segundos, temperatura não inferior a 20 °C). O segredo para ter nosso processo sob controle estatístico é garantir que a sua faixa de variablidade de, por exemplo, mais ou menos três desvios padrão em torno do valor médio, caiba inteiramente dentro da faixa de valores de tolerância para a variável do processo que está sendo avaliada.
Ou, expressando algebicamente, o que queremos é que seja satisfeito o seguinte sistema de inequações:
Em que LST significa limite superior de tolerância, e LIT significa limite inferior de tolerância. Obviamente, se os requisitos do processo para a nossa variável for do tipo "não superior a..." ou "não inferior a...", então somente uma das equações acima deverá ser satisfeita.
O resultado disto é que podemos afirmar que existe 99,8% de probabilidade do resultado do nosso processo estar em conformidade com os requisitos. Porém, apesar disso parecer genial (e é...), existem algumas outras coisinhas com as quais se preocupar:
- Para que este método de gestão da qualidade dos processos funcione é importante escolher com cuidado quais variáveis decontrole serão observadas. Isto é especialmente verdade em processos com várias fases. E isto levanta outro problema estatístico delicado: como avaliar a forma e o grau de correlação entre o comportamento da variável de controle escolhida e a aderência do resultado do processo aos limites de tolerância;
- Toda a discussão acima assume que a distribuição de frequência da variável de controle é normal. Se isto não for verdade, então a idéia básica ainda funciona, mas são necessárias adaptações;
- Nunca assuma que causas especiais de variabilidade estão ausentes só porque você já passou o pente fino no seu processo. Elas tem o hábito de entrar insidiosamente e quando menos se espera. Vigilância sempre.
sexta-feira, 1 de julho de 2011
Disponibilidade (2)
No artigo anterior revisamos os aspectos básicos do cálculo da disponibilidade. Mas, e se o conjunto de elementos que tivermos que considerar for mais complicado que somente um conjunto de elementos ligados em série ou em paralelo?
Nada como um exemplo concreto para tornar palpáveis conceitos abstratos. Então vamos imaginar a seguinte situação. Uma rede IP/MPLS de alta disponibilidade, configurada em uma topologia de double hub'n'spoke, tem a topologia típica dos seus edge sites da seguinte forma:
Cada uma das VLANs separa logicamente o tráfego de uma VRF defiida na rede MPLS. Em cada VLAN (que pode ou não estar associada a outras L2 switches do edge site) o par de interfaces (fisicas ou virtuais) das L3 switches forma um par redundante VRRP (ou HSRP se o ambiente for puro Cisco Systems). As L3 switches atuam como roteadores PE da rede MPLS, e a redundância de rotas entre elas (cursando pelos roteadores P de concentração local e dos hubs) é garantida pelos mecanismos normais do MPLS - possivelente, mas não obrigatoriamente, usando recursos de MPLS-TE e FRR.
Como vimos no artigo anterior deste tópico (só planejo escrever mais este artigo sobre este assunto, então é muito pouco para chamar de "série"), o MTTR é fundamental para determinar o número de "noves" de disponibilidade. Nestas situações, quem define o MTTR é o tempo de reconvergência das rotas após algum evento. Para ser mais preciso, o tempo que, na análise da distribuição estatística dos tempos de reconvergência para um determinado evento (supostamente normal) corresponda à média mais dois (ou três) desvios-padrão. Então muita atenção deve ser dada à configuração dos intervalos de tempo entre mensagens de keepalive e os timeouts para iniciar o recálculo de rotas do VRRP/HSRP e do MPLS. Na verdade a maneira correta de determinar a disponibilidade para todo o edge site deveria levar em conta as probabilidades de ocorrência de cada modo de falha do site (como veremos abaixo) e seus respectivos MTTRs.
Como eu nunca vi ninguém fazer isto na vida real, nem mesmo com aproximações verificadas em bancada de laboratório, a alternativa é trabalhar a partir da disponibilidade esperada para cada elemento individual. Fazendo um diagrame esquemático dos elementos relevantes para a disponibilidade do edge site temos o seguinte:
Como suposição inicial, vamos admitir que a disponibilidade dos elementos de hardware (VLAN de acesso, L3 switches e roteadores P) é de quatro "noves" - 99,99% ou 0,9999; que a disponibilidade das conexões PE-P é de três "noves" - 99,9% ou 0,999 (não estranhe isso, porque muitos eventos de alteração topológica ocorrem por erros operacionais nas manobras do cabeamento); e que a disponibilidade dos links WAN também seja de três "noves" (não está muito diferente do observado na prática).
Cada um destes elementos pode, em um determinado instante, estar funcionando ou não. Temos, então, uma situação onde 11 elementos podem, individualmente, assumir um entre dois estados possíveis. Quantas configurações diferentes (modos de falha) podem ocorrer? Simples: cada estado operacional do edge site pode ser representado como um número binário com 11 dígitos, portanto existem 2^11 = 2048 estados diferentes.
Fazemos uma tabulação destes estados (uma medalha para os inventores das planilhas eletrônicas!) conforme mostrada abaixo (visão somente de primeiras 8 das 2048 colunas de estado do sistema).
Em cada coluna de estado o valor zero representa que aquele elemento encontra-se em funcionamento, e o valor 1 significa que o elemento está fora de serviço. Calcula-se a probabilidade de ocorrência do estado fazendo o produtório dos valores da disponibilidade (A) dos elementos que estiverem com estado operacional igual a zero e dos valores da indisponibilidade (1 - A) dos elementos que estiverem com estado operacional igual a um. Agora é necessário avaliar se cada estado individual causa ou não a interrupção da comunicação do edge site. Os estados que interrompem a comunicação satisfazem à seguinte expressão lógica:
Muito bem. Os valores que estão na planilha são típicos dos equipamentos e serviços de comunicação que encontramos na praça. E vemos que esta combinação nos dá uma disponibilidade total de apenas três "noves", bem perto de chegar a quatro "noves".
Só que isto é empurrado goela abaixo das operadoras de rede como sendo uma configuração de cinco "noves"! E isto não é verdade. Sendo otimista, a disponibilidade real é cerca de dez vezes menor que a desejada como parâmetro de projeto.
Brincando ainda mais com a planilha observ-se que o elemento dominante da disponibilidade total do edge site são os links WAN. Melhorar os "noves" de todo o resto influencia muito pouco no resultado total. Por exemplo, se todos os outros elementos tiverem cinco "noves" de disponibilidade, mantida a situação dos links WAN com três "noves", não altera o valor global para A (as mudanças ocorrem pralá da sexta casa decimal).
Porém se os links WAN passarem a quatro "noves", mantendo os demais elementos na forma inicial, a disponibilidade global passa a quatro "noves" redondinhos. Conclusão: se quisermos um ambiente de rede que atenda ao critério de cinco "noves" de disponibilidade, que é propalado como típico de redes de telecom, todos os elementos da rede devem ter cinco "noves" de disponibilidade, porque o elo mais fraco atrai a disponibilidade de todo o conjunto em direção a ele.
O que eu concluo disto tudo? Duas coisas:
Nada como um exemplo concreto para tornar palpáveis conceitos abstratos. Então vamos imaginar a seguinte situação. Uma rede IP/MPLS de alta disponibilidade, configurada em uma topologia de double hub'n'spoke, tem a topologia típica dos seus edge sites da seguinte forma:
![]() |
| Topologia típica do edge site |
Como vimos no artigo anterior deste tópico (só planejo escrever mais este artigo sobre este assunto, então é muito pouco para chamar de "série"), o MTTR é fundamental para determinar o número de "noves" de disponibilidade. Nestas situações, quem define o MTTR é o tempo de reconvergência das rotas após algum evento. Para ser mais preciso, o tempo que, na análise da distribuição estatística dos tempos de reconvergência para um determinado evento (supostamente normal) corresponda à média mais dois (ou três) desvios-padrão. Então muita atenção deve ser dada à configuração dos intervalos de tempo entre mensagens de keepalive e os timeouts para iniciar o recálculo de rotas do VRRP/HSRP e do MPLS. Na verdade a maneira correta de determinar a disponibilidade para todo o edge site deveria levar em conta as probabilidades de ocorrência de cada modo de falha do site (como veremos abaixo) e seus respectivos MTTRs.
Como eu nunca vi ninguém fazer isto na vida real, nem mesmo com aproximações verificadas em bancada de laboratório, a alternativa é trabalhar a partir da disponibilidade esperada para cada elemento individual. Fazendo um diagrame esquemático dos elementos relevantes para a disponibilidade do edge site temos o seguinte:
![]() |
| Elementos críticos para a disponibilidade do edge site |
Cada um destes elementos pode, em um determinado instante, estar funcionando ou não. Temos, então, uma situação onde 11 elementos podem, individualmente, assumir um entre dois estados possíveis. Quantas configurações diferentes (modos de falha) podem ocorrer? Simples: cada estado operacional do edge site pode ser representado como um número binário com 11 dígitos, portanto existem 2^11 = 2048 estados diferentes.
Fazemos uma tabulação destes estados (uma medalha para os inventores das planilhas eletrônicas!) conforme mostrada abaixo (visão somente de primeiras 8 das 2048 colunas de estado do sistema).
![]() |
| Planilha de estados do sistema |
Em cada coluna de estado o valor zero representa que aquele elemento encontra-se em funcionamento, e o valor 1 significa que o elemento está fora de serviço. Calcula-se a probabilidade de ocorrência do estado fazendo o produtório dos valores da disponibilidade (A) dos elementos que estiverem com estado operacional igual a zero e dos valores da indisponibilidade (1 - A) dos elementos que estiverem com estado operacional igual a um. Agora é necessário avaliar se cada estado individual causa ou não a interrupção da comunicação do edge site. Os estados que interrompem a comunicação satisfazem à seguinte expressão lógica:
- [VLAN de acesso = 1] OU;
- [ [L3 switch (1) = 1] E [L3 switch (2) =1] ] OU;
- [ [Conexão PE-P (1) =1] E [Conexão PE-P (2) =1] E [Conexão PE-P (3) =1] E [Conexão PE-P (4) =1] ] OU;
- [ [Link WAN (1) = 1] E [Link WAN (2) =1] ]
Muito bem. Os valores que estão na planilha são típicos dos equipamentos e serviços de comunicação que encontramos na praça. E vemos que esta combinação nos dá uma disponibilidade total de apenas três "noves", bem perto de chegar a quatro "noves".
Só que isto é empurrado goela abaixo das operadoras de rede como sendo uma configuração de cinco "noves"! E isto não é verdade. Sendo otimista, a disponibilidade real é cerca de dez vezes menor que a desejada como parâmetro de projeto.
Brincando ainda mais com a planilha observ-se que o elemento dominante da disponibilidade total do edge site são os links WAN. Melhorar os "noves" de todo o resto influencia muito pouco no resultado total. Por exemplo, se todos os outros elementos tiverem cinco "noves" de disponibilidade, mantida a situação dos links WAN com três "noves", não altera o valor global para A (as mudanças ocorrem pralá da sexta casa decimal).
Porém se os links WAN passarem a quatro "noves", mantendo os demais elementos na forma inicial, a disponibilidade global passa a quatro "noves" redondinhos. Conclusão: se quisermos um ambiente de rede que atenda ao critério de cinco "noves" de disponibilidade, que é propalado como típico de redes de telecom, todos os elementos da rede devem ter cinco "noves" de disponibilidade, porque o elo mais fraco atrai a disponibilidade de todo o conjunto em direção a ele.
O que eu concluo disto tudo? Duas coisas:
- Ninguém está, de fato, construindo redes de altíssima disponibilidade, e;
- As redes de telecom nunca tiveram, realmente, uma disponibilidade tão alta quanto anunciado.
sexta-feira, 17 de junho de 2011
Sistemas de numeração 4 - Generalizando a aritmética: subtração de dois inteiros
Esta é mais uma das minhas séries que andava meio paradona, e que este deve ser o último post. Creio que, depois daqui, qualquer leitor que queira prosseguir para outras operações, ou queira enveredar pelo caminho mais abstrato da teoria dos números, já tenha sido propriamente estimulado e possa seguir adiante com esforço próprio.
Nosso problema de hoje é: conhecidas as representações b-árias dos números inteiros X (chamado minuendo) e Y (chamado subtraendo) tais que
Encontrar um procedimento genérico para determinar a representação b-ária do número inteiro D (diferença) tal que D = X - Y.
Na nossa já conhecida expansão nos polinômios de representação de acordo com o TGE (cujo enunciado e prova estão no primeiro post desta série), temos então que:
Novamente, como no caso da soma, temos duas possibilidades para o coeficiente di. O primeiro deles é:
Quando isto ocorre o valor do coeficiente di é obtido diretamente da subtração dos valores dos coeficientes xi (do minuendo) e yi (do subtraendo). As tabelas de tabuada da soma dos algarismos para os sistemas binário, decimal e hexadecimal apresentadas no post anterior desta série podem ser usadas para simplificar a tarefa de execução desta subtração. Obviamente o segundo caso será:
Para resolver este impasse nós vamos recorrer a uma consequência da nossa hipótese inicial que X seja maior ou igual a Y: existe na representação b-ária do minuendo pelo menos um algarismo não nulo cuja ordem de grandeza é maior que i (a ordem de grandeza considerada no momento).
Porque isto é verdade? Simples: se isto não fosse verdade então xi seria o dígito de maior ordem de grandeza na representação b-ária do minuendo; mas se ele for o dígito de mais alta ordem ele não pode ser menor que o dígito de ordem de grandeza equivalente na representação do subtraendo, o que contraria a situação inicial que assumimos.
Como existe este dígito xj (j > i), então podemos fazer o seguinte desdobramento:
Como, obviamente b + xi > yi , recaímos no primeiro caso. Vale observar que este "empréstimo" de uma ordem superior altera efetivamente os valores dos coeficientes do termo que fez a cessão e de todos os eventuais termos com coeficiente nulo existentes entre ele e o termo que recebe a cessão. Esta modificação tem de ser levada em conta quando, na execução do algoritmo, formos tratar os termos de ordem superior.
Considerando o que dissemos acima, nosso algoritmo generalizado para a subtração de dois números inteiros fica da seguiinte forma:
Creio que isso chega para meus propósitos. Para quem quiser continuar nesta linha de raciocínio, o algoritmo da multiplicação é bem fácil de desenvolver, e fica fácil de entender a necessidade do deslocamento de uma ordem de grandeza para cima para cada novo algorismo do multiplicador que vai operar sobre os algarismos do multiplicando. Também é fácil deduzir as tabuadas de multiplicação necessárias para cada sistema de numeração de uso mais comum (binário, decimal e hexadecimal).
O algoritmo da divisão é um pouco mais sutil, mas não é difícil. Se alguém quiser mais dados sobre isso é só gritar (os comentários estão abertos para todos os posts). Inté a próxima.
Nosso problema de hoje é: conhecidas as representações b-árias dos números inteiros X (chamado minuendo) e Y (chamado subtraendo) tais que
Encontrar um procedimento genérico para determinar a representação b-ária do número inteiro D (diferença) tal que D = X - Y.
Na nossa já conhecida expansão nos polinômios de representação de acordo com o TGE (cujo enunciado e prova estão no primeiro post desta série), temos então que:
Novamente, como no caso da soma, temos duas possibilidades para o coeficiente di. O primeiro deles é:
Quando isto ocorre o valor do coeficiente di é obtido diretamente da subtração dos valores dos coeficientes xi (do minuendo) e yi (do subtraendo). As tabelas de tabuada da soma dos algarismos para os sistemas binário, decimal e hexadecimal apresentadas no post anterior desta série podem ser usadas para simplificar a tarefa de execução desta subtração. Obviamente o segundo caso será:
Para resolver este impasse nós vamos recorrer a uma consequência da nossa hipótese inicial que X seja maior ou igual a Y: existe na representação b-ária do minuendo pelo menos um algarismo não nulo cuja ordem de grandeza é maior que i (a ordem de grandeza considerada no momento).
Porque isto é verdade? Simples: se isto não fosse verdade então xi seria o dígito de maior ordem de grandeza na representação b-ária do minuendo; mas se ele for o dígito de mais alta ordem ele não pode ser menor que o dígito de ordem de grandeza equivalente na representação do subtraendo, o que contraria a situação inicial que assumimos.
Como existe este dígito xj (j > i), então podemos fazer o seguinte desdobramento:
Como, obviamente b + xi > yi , recaímos no primeiro caso. Vale observar que este "empréstimo" de uma ordem superior altera efetivamente os valores dos coeficientes do termo que fez a cessão e de todos os eventuais termos com coeficiente nulo existentes entre ele e o termo que recebe a cessão. Esta modificação tem de ser levada em conta quando, na execução do algoritmo, formos tratar os termos de ordem superior.
Algoritmo geral da subtração
Considerando o que dissemos acima, nosso algoritmo generalizado para a subtração de dois números inteiros fica da seguiinte forma:
- Escreva as representações b-árias de X e Y uma sobe a outra, mantendo alinhamento vertical dos dígitos de mesma ordem de grandeza a partir da menor ordem de grandeza (da direita para a esquerda);
- i = 0;
- xi < yi ?
SIM: vá para o passo 10
NÃO: vá para o passo 4; - Consultando a tabuada da soma b-ária efetue a subtração xi - yi;
- Escreva o dígito da diferença nesta ordem de grandeza (i) usando o algarismo b-ário cujo valor corresponde ao resultado do passo (4);
- Ainda existem dígitos de ordem mais alta que a atual na representação de X?
SIM: vá para o passo 7
NÃO: vá para o passo 19; - i = i + 1;
- Vá para o passo 3;
- j = i + 1;
- xj é um dígito não nulo?
SIM: vá para o passo 13
NÃO: vá para o passo 11; - j = j + 1;
- Vá para o passo 11;
- xj = xj - 1;
- j = j - 1;
- j = i ?
SIM: vá para o passo 16
NÃO: vá para o passo 18; - xi = b + xi;
- Vá para o passo 4;
- Vá para o passo 15;
- FIM.
Creio que isso chega para meus propósitos. Para quem quiser continuar nesta linha de raciocínio, o algoritmo da multiplicação é bem fácil de desenvolver, e fica fácil de entender a necessidade do deslocamento de uma ordem de grandeza para cima para cada novo algorismo do multiplicador que vai operar sobre os algarismos do multiplicando. Também é fácil deduzir as tabuadas de multiplicação necessárias para cada sistema de numeração de uso mais comum (binário, decimal e hexadecimal).
O algoritmo da divisão é um pouco mais sutil, mas não é difícil. Se alguém quiser mais dados sobre isso é só gritar (os comentários estão abertos para todos os posts). Inté a próxima.
quarta-feira, 15 de junho de 2011
Sistemas de Computação 9 - Memória virtual
Bom pessoal, acho que vamos, finalmente, chegar ao fim (pelo menos como eu havia pensado) desta série de artigos sobre os elementos básicos de funcionamento dos sistemas de computação. Este último tópico, sobre memória virtual, vai ser dividido em duas partes. Na primeira parte vamos ver como virtualizar, do ponto de vista dos programas de aplicação, o endereçamento de instruções e operandos na memória via address translation. Na segunda parte vamos ver o algoritmo mais comum para administrar a alocação da memória real aos vários processos em execução sob controle do kernel do sistema operacional: demand paging.
Address translation
Pois bem. Para nossa primeira parte vamos precisar, assim como no caso do compartilhamento do tempo do processador, de uma mãozinha do hardware (e/ou do microcódigo) do processador. Este auxílio vem na forma da automação do processo de address translation, que calcula o endereço real de memória correspondente ao endereço virtual de uma instrução ou operando de instrução (e, em princípio, todas as referências a endereços de instrução ou de operandos de instrução são considerados virtuais).
O espaço de enderaçamento (address space) virtual, conforme visto pelos programas de aplicação, é um bloco contínuo de bytes de memória, cada byte identiicado por um endereço binário. Para efeito de exemplo vamos supor que estamos trabalhando coom um processador com endereços de memória de 32 bits. Então o espaço de endereçamento visualizado pelos programas de aplicação tem a aparência mostrada na figura abaixo (endereços binários expressos pelos seus equivalentes em hexadecimal).
Este address space virtual é dividido logicamente em páginas (pages) de tamanho fixo. No nosso caso de exemplo vamos supor que cada página tenha 4K bytes de tamanho. Então a visão lógica do address space virtual repartido em páginas fica como mostrado na próxima figura.
Então podemos ver que um endereço virtual tem uma estrutura lógica, com os 12 bits menos significativos (correspondentes aos 3 dígitos hexadecimais menos significativos) representando o deslocamento (displacement) em relação ao início da página, e com os 20 bits mais significativos (os 5 dígitos hexadecimais mais significativos) identificando o número da página (page number).
Por questões de ordem prática (minimizar a quantidade de memória usada pelo kernel para representar o mapa da memória virtual, que tende a ser uma tabela esparsa), a maioria dos processadores inclui mais um degrau no processo de address translation, considerando o número da página dividido logicamente em duas partes: número do segmento (segment number) e número da página. Assumindo que, no nosso caso de exemplo, o número da página tenha 12 bits e o número do segmento tenha 8 bits, a estrutura lógica do nosso endereço virtua de exemplo será da seguinte forma:
A memória real (aquela que está fisicamente instalada na máquina e que, geralmente, é bem menor que o address space virtual - 4G bytes no nosso exemplo) também é dividida logicamente em frames (molduras) com o mesmo tamanho das páginas do address space virtual (4K bytes no nosso caso de exemplo).
O objetivo desta estruturação lógica é, obviamente, permitir que haja um "descasamento" entre a localização física real de um byte na memória e a sua localização lógica do ponto de vista do programa de aplicação, e que esta localização física possa ser modificada, mesmo durante a execução do programa.
Para isto o kernel mantém uma tabela inicial chamada tabela de segmentos (segment table) cuja localização (segment table address) é armazenada em um local específico da memória real acessado pelo mecanismo de address translation do hardware. Cada entrada da segment table contém o endereço do início da tabela de páginas (page table) associada àquele segmento do address space virtual. No jargão técnico de programação o conteúdo de cada entrada na segment table é denominado um ponteiro (pointer) para a localização da page table associada ao segmento. No nosso caso de exemplo cada entrada da segment table tem, portanto, 4 bytes (32 bits) de tamanho.
Cada entrada de uma page table, por sua vez, contém o número do frame (frame number) - com 20 bits no nosso caso de exemplo - onde aquela página virtual está fisicamente armazenada. Cada entrada nas page tables tem de acomodar, além do frame number, mais três bits de controle. Então, arredondando para um número inteiro de bytes, no nosso caso exemplo o tamanho de uma entrada na page table é de: 20 bits do frame number + 3 bits de controle + 1 bit de arredondamento = 24 bits (3 bytes). A figura abaixo representa esquematicamente estas estruturas de dados criadas e mantidas pelo kernel.
Então, vejamos quando e como ocorre o processo de address translation. O quando é fácil: sempre que é necessário executar um acesso à memória. Isto corresponde às fases de instruction fetch, operand fetch, result store e load interrupt vector address into program counter, conforme a versão mais recente apresentada no artigo anterior desta série.
O como é assim. Todo endereço virtual é separado nos seus componentes: segment number, page number e displacement. Com estes componentes, e com os demais dados na segment table e nas page tables, efetua-se o cálculo do endereço real conforme mostrado na figura abaixo
Isto nos mostra como o endereço virtual é usado para calcular o endereço real correspondente, mas nada dissemos, ainda, sobre como gerenciar a alocação dos frames da memória real aos diversos processos em execução sob controle do kernel. Este é o papel do algoritmo que veremos a seguir.
Quando o kernel recebe uma requisição para iniciar um processo ele precisa alocar memória para o(s) programa(s) deste novo processo dentro do address space virtual. Isto é feito alocando-se o número apropriado de páginas virtuais livres contíguas nas page tables. Isto pode ser feito localizando-se nas page tabes já criadas entradas com o bit de controle V (valid) igual a zero, significando que aquelas páginas estão inválidas (portanto livres); ou então podem ser acrescentadas novas entradas na segment table (até o limite do tamanho do address space virtual) e suas respectivas page tables. Em qualquer caso, a partir deste momento estas páginas são consideradas válidas (em uso), e os seus bits V são tornados iguais a 1.
Depois é feita a associação dos frames da memória real às páginas da memória virtual. Para isto o kernel mantém uma lista dos frames livres, conhecida como free list. Para cada página virtual alocada é retirada uma entrada da free list, o seu frame number é colocado na entrada correspondente da page table e o conteúdo da página, caso exista, é copiado para a memória real e para um arquivo externo de baixa latência de acesso (tipicamente em disco magnético) conhecido como arquivo de páginas (page file)
Durante o processo de alocação da memória real pode acontecer de não haver entradas suficientes na free list para satisfazer à necessidade de alocação do novo processo. Esta é uma das situações onde ocorre uma falta de página (page fault). A outra situação onde isto pode ocorrer é durante a sequência normal de execução dos processos, como veremos adiante.
Para solucionar a falta de página o kernel tem que fazer o "reabastecimento" da free list (free list replenishment). Antes de explicar como isto é feito temos que entender o significado e a utilização dos outros dois bits de controle (R e C) nas entradas das page tables.
Toda vez que ocorre uma referência (fetch) a uma instrução ou a um operando contido em uma página, então o seu bit R (reference) é ligado (tornado igual a 1). Periodicamente o kernel desliga (torna iguais a zero) os bits R de todas as páginas. Desta forma páginas que tenham o bit R desligado são páginas que não sofreram referência pelo seu processo pelo menos desde a últia vez em que todos os bits R foram desligados pelo kernel.
Toda vez que ocorre uma alteração (store) do conteúdo de uma página então o kernel liga o seu bit C (change) para indicar que o conteúdo desta página na memória real não é mais igual à sua cópia armazenada no page file. Este bit é desligado sempre que uma página é carregada em um frame de memória real, na alocação inícial dos processos ou na solução do segundo tipo de ocorrência dos page faults.
Assim a estratégia para localizar páginas favoráveis para reabastecer a free list é:
Porque este algoritmo funciona? Desde que o volume de operações de I/O sobre o page file - conhecidas simplesmente como paging, ou page-in e page-out - não seja muito elevado, então o fato observado experiementalmente é que apenas as páginas mais referenciadas de cada processo (conhecidas como o active page set do processo) tendem a ficar na memória real. Claro que o ideal é que o sistema não tenha que fazer paging. Como isto raramente é viável economicamente (embora o preço decrescente dos chips de memória estejam alterando isto), um dos fatores críticos de performance do sistema é determinar até que ponto é tolerável a ocorrência de paging.
Para terminar este assunto só precisamos abordar dois detalhes.
O primeiro é justamente o que viabiliza a construção de sistemas operacionais onde cada um dos seus "processos" é um ambiente computacional virtual completo. Para isso o que precisamos, essencialmente, é permitir que cada processo acredite ter um address space virtual inteiro só para ele. Para conseguir isso basta criar uma segment table (e page tables associadas) para cada processo, e adaptar o cálculo de address translation a este fato.
O segundo detalhe é que neste tipo de ambiente é muito fácil fazer que múltiplos processos compartilhem segmentos da memória real entre eles. Basta fazer com que as respectivas entradas das segment tables de cada processo apontem para o mesmo conjunto de page tables, ou que entradas de page table de cada processo referenciem o mesmo frame number. Isto é especialmente útil se o sistema tive que executar instâncias de um mesmo programa em múltiplos processos distintos. Neste caso alocam-se páginas distintas para acomodar os operandos de cada instância, enquanto as instruções do programa podem ser mantidas em uma única instância física, mas referenciada como instâncias distintas nas segment e page tables dos processos.
Por ora é só. A menos que alguém tenha algum pedido específico, encerro esta série de artigos sobre sistemas de computação por aqui.
Address translation
Pois bem. Para nossa primeira parte vamos precisar, assim como no caso do compartilhamento do tempo do processador, de uma mãozinha do hardware (e/ou do microcódigo) do processador. Este auxílio vem na forma da automação do processo de address translation, que calcula o endereço real de memória correspondente ao endereço virtual de uma instrução ou operando de instrução (e, em princípio, todas as referências a endereços de instrução ou de operandos de instrução são considerados virtuais).
O espaço de enderaçamento (address space) virtual, conforme visto pelos programas de aplicação, é um bloco contínuo de bytes de memória, cada byte identiicado por um endereço binário. Para efeito de exemplo vamos supor que estamos trabalhando coom um processador com endereços de memória de 32 bits. Então o espaço de endereçamento visualizado pelos programas de aplicação tem a aparência mostrada na figura abaixo (endereços binários expressos pelos seus equivalentes em hexadecimal).
Este address space virtual é dividido logicamente em páginas (pages) de tamanho fixo. No nosso caso de exemplo vamos supor que cada página tenha 4K bytes de tamanho. Então a visão lógica do address space virtual repartido em páginas fica como mostrado na próxima figura.
Então podemos ver que um endereço virtual tem uma estrutura lógica, com os 12 bits menos significativos (correspondentes aos 3 dígitos hexadecimais menos significativos) representando o deslocamento (displacement) em relação ao início da página, e com os 20 bits mais significativos (os 5 dígitos hexadecimais mais significativos) identificando o número da página (page number).
Por questões de ordem prática (minimizar a quantidade de memória usada pelo kernel para representar o mapa da memória virtual, que tende a ser uma tabela esparsa), a maioria dos processadores inclui mais um degrau no processo de address translation, considerando o número da página dividido logicamente em duas partes: número do segmento (segment number) e número da página. Assumindo que, no nosso caso de exemplo, o número da página tenha 12 bits e o número do segmento tenha 8 bits, a estrutura lógica do nosso endereço virtua de exemplo será da seguinte forma:
A memória real (aquela que está fisicamente instalada na máquina e que, geralmente, é bem menor que o address space virtual - 4G bytes no nosso exemplo) também é dividida logicamente em frames (molduras) com o mesmo tamanho das páginas do address space virtual (4K bytes no nosso caso de exemplo).
O objetivo desta estruturação lógica é, obviamente, permitir que haja um "descasamento" entre a localização física real de um byte na memória e a sua localização lógica do ponto de vista do programa de aplicação, e que esta localização física possa ser modificada, mesmo durante a execução do programa.
Para isto o kernel mantém uma tabela inicial chamada tabela de segmentos (segment table) cuja localização (segment table address) é armazenada em um local específico da memória real acessado pelo mecanismo de address translation do hardware. Cada entrada da segment table contém o endereço do início da tabela de páginas (page table) associada àquele segmento do address space virtual. No jargão técnico de programação o conteúdo de cada entrada na segment table é denominado um ponteiro (pointer) para a localização da page table associada ao segmento. No nosso caso de exemplo cada entrada da segment table tem, portanto, 4 bytes (32 bits) de tamanho.
Cada entrada de uma page table, por sua vez, contém o número do frame (frame number) - com 20 bits no nosso caso de exemplo - onde aquela página virtual está fisicamente armazenada. Cada entrada nas page tables tem de acomodar, além do frame number, mais três bits de controle. Então, arredondando para um número inteiro de bytes, no nosso caso exemplo o tamanho de uma entrada na page table é de: 20 bits do frame number + 3 bits de controle + 1 bit de arredondamento = 24 bits (3 bytes). A figura abaixo representa esquematicamente estas estruturas de dados criadas e mantidas pelo kernel.
Então, vejamos quando e como ocorre o processo de address translation. O quando é fácil: sempre que é necessário executar um acesso à memória. Isto corresponde às fases de instruction fetch, operand fetch, result store e load interrupt vector address into program counter, conforme a versão mais recente apresentada no artigo anterior desta série.
O como é assim. Todo endereço virtual é separado nos seus componentes: segment number, page number e displacement. Com estes componentes, e com os demais dados na segment table e nas page tables, efetua-se o cálculo do endereço real conforme mostrado na figura abaixo
Isto nos mostra como o endereço virtual é usado para calcular o endereço real correspondente, mas nada dissemos, ainda, sobre como gerenciar a alocação dos frames da memória real aos diversos processos em execução sob controle do kernel. Este é o papel do algoritmo que veremos a seguir.
Demand paging
Quando o kernel recebe uma requisição para iniciar um processo ele precisa alocar memória para o(s) programa(s) deste novo processo dentro do address space virtual. Isto é feito alocando-se o número apropriado de páginas virtuais livres contíguas nas page tables. Isto pode ser feito localizando-se nas page tabes já criadas entradas com o bit de controle V (valid) igual a zero, significando que aquelas páginas estão inválidas (portanto livres); ou então podem ser acrescentadas novas entradas na segment table (até o limite do tamanho do address space virtual) e suas respectivas page tables. Em qualquer caso, a partir deste momento estas páginas são consideradas válidas (em uso), e os seus bits V são tornados iguais a 1.
Depois é feita a associação dos frames da memória real às páginas da memória virtual. Para isto o kernel mantém uma lista dos frames livres, conhecida como free list. Para cada página virtual alocada é retirada uma entrada da free list, o seu frame number é colocado na entrada correspondente da page table e o conteúdo da página, caso exista, é copiado para a memória real e para um arquivo externo de baixa latência de acesso (tipicamente em disco magnético) conhecido como arquivo de páginas (page file)
Durante o processo de alocação da memória real pode acontecer de não haver entradas suficientes na free list para satisfazer à necessidade de alocação do novo processo. Esta é uma das situações onde ocorre uma falta de página (page fault). A outra situação onde isto pode ocorrer é durante a sequência normal de execução dos processos, como veremos adiante.
Para solucionar a falta de página o kernel tem que fazer o "reabastecimento" da free list (free list replenishment). Antes de explicar como isto é feito temos que entender o significado e a utilização dos outros dois bits de controle (R e C) nas entradas das page tables.
Toda vez que ocorre uma referência (fetch) a uma instrução ou a um operando contido em uma página, então o seu bit R (reference) é ligado (tornado igual a 1). Periodicamente o kernel desliga (torna iguais a zero) os bits R de todas as páginas. Desta forma páginas que tenham o bit R desligado são páginas que não sofreram referência pelo seu processo pelo menos desde a últia vez em que todos os bits R foram desligados pelo kernel.
Toda vez que ocorre uma alteração (store) do conteúdo de uma página então o kernel liga o seu bit C (change) para indicar que o conteúdo desta página na memória real não é mais igual à sua cópia armazenada no page file. Este bit é desligado sempre que uma página é carregada em um frame de memória real, na alocação inícial dos processos ou na solução do segundo tipo de ocorrência dos page faults.
Assim a estratégia para localizar páginas favoráveis para reabastecer a free list é:
- Liberar (desligando o bit V) primeiro as páginas que tiverem o bit R igual a zero (não referenciadas recentemente) e o bit C igual a zero (não modificadas desde a sua carga na memória real). Como a cópia destas páginas no page file ainda é válida, elas podem ser reaproveitadas sumariamente;
- Se ainda forem necessárias mais páginas que as recuperadas pelo passo anterior, a próxima opção é liberar as páginas que tenham R=0 e C=1. Neste caso antes de reaproveitar o frame é necessário atualizar a cópia da página no page file, porque ela já sofreu alterações;
- Caso sejam necessárias mais páginas ainda, a última opção (e a mais danosa à performance) é selecionar páginas com R=1 e C=1, atualizando a cópia da página no page file antes do reaproveitamento do frame.
Porque este algoritmo funciona? Desde que o volume de operações de I/O sobre o page file - conhecidas simplesmente como paging, ou page-in e page-out - não seja muito elevado, então o fato observado experiementalmente é que apenas as páginas mais referenciadas de cada processo (conhecidas como o active page set do processo) tendem a ficar na memória real. Claro que o ideal é que o sistema não tenha que fazer paging. Como isto raramente é viável economicamente (embora o preço decrescente dos chips de memória estejam alterando isto), um dos fatores críticos de performance do sistema é determinar até que ponto é tolerável a ocorrência de paging.
Múltiplos address spaces virtuais e compartilhamento de código
Para terminar este assunto só precisamos abordar dois detalhes.
O primeiro é justamente o que viabiliza a construção de sistemas operacionais onde cada um dos seus "processos" é um ambiente computacional virtual completo. Para isso o que precisamos, essencialmente, é permitir que cada processo acredite ter um address space virtual inteiro só para ele. Para conseguir isso basta criar uma segment table (e page tables associadas) para cada processo, e adaptar o cálculo de address translation a este fato.
O segundo detalhe é que neste tipo de ambiente é muito fácil fazer que múltiplos processos compartilhem segmentos da memória real entre eles. Basta fazer com que as respectivas entradas das segment tables de cada processo apontem para o mesmo conjunto de page tables, ou que entradas de page table de cada processo referenciem o mesmo frame number. Isto é especialmente útil se o sistema tive que executar instâncias de um mesmo programa em múltiplos processos distintos. Neste caso alocam-se páginas distintas para acomodar os operandos de cada instância, enquanto as instruções do programa podem ser mantidas em uma única instância física, mas referenciada como instâncias distintas nas segment e page tables dos processos.
Por ora é só. A menos que alguém tenha algum pedido específico, encerro esta série de artigos sobre sistemas de computação por aqui.
sexta-feira, 13 de maio de 2011
Sistemas de Computação 8 - Compartilhamento do tempo do processador
Muy bueno... pelo que vimos até agora existem alguns mistérios entre as coisas feitas pelo kernel do sistema operacional, e neste post vamos resolver um deles. Se, pelo que vimos da arquitetura Von Neumann e do ciclo fetch-execute, o processador só é capaz de executar um programa de cada vez (com a exceção óbvia das máquinas multiprocessadas e dos processadores com múltiplos núcleos) então como o sistema operacional consegue criar a ilusão de execução simultânea de vários programas?
A resposta é simples. Intercalando no tempo a execução dos vários programas do(s) usuário(s), e fazendo isto tão rápido que, para o observador humano, a aparência é de execução simultânea. Esta técnica é chamada de multitasking (multiprogramação), e o algoritmo mais popular para realizá-la é o time-sharing. Mas este algritmo necessita que o hardware (e/ou o microcódigo) implemente o mecanismo de interrupções (interrupts). Portanto vamos primeiro falar disso.
Uma interrupção, como o nome indica, é um evento que provoca uma quebra na sequência normal do ciclo fetch-execute, através de um desvio incondicional para uma rotina de tratamento da interrupção (que tem de estar previamente carregada na memória, mas isto é papel do kernel durante a inicialização do sistema operacional) chamada interrupt handler.
A sinalização da interrupção pode ser gerada por algum elemento de hardware (ex.: o controlador de um dispositivo ao término de uma operação de I/O físico), ou pelo próprio programa em execução (este é o modo geral para invocar os serviços da API de system calls do sistema operacional). Cada tipo de interrupção suportado pelo processador possui um interrupt handler associado. Os endereços de memória correspondentes à primeira instrução de cada interrupt handler ficam armazenados em posições contíguas da memória, denominadas interrupt vector (IV).
Mas, para que este esquema possa funcionar, é necessário preservar o estado dos registradores do processador no momento da interrupção (em especial o program counter - PC), para que o programa que foi interrompido possa retornar a executar normalmente daquele ponto em diante. Isto é chamado de salvar o contexto do processo - que é o "apelido" para um programa executando sob o controle do kernel. Existem várias técnicas para salvar o contexto do processo. Por exemplo: usar uma estrutura de dados do kernel chamada stack (pelo que sei os processadores Intel desde o 8086 até o Pentium são assim), ou convencionar que cada rotina alvo de um desvio deve reservar memória e executar o salvamento do contexto da rotina de origem do desvio (como na programação assembly para mainframes IBM /370 e /370-XA. Creio que nas arquiteturas ESA/390 e z-Architecture ainda seja assim).
Ótimo. com todas estas peças no lugar, só precisamos agora mudar um pouquinho o nosso ciclo fetch-execute para incorporar a verificação da ocorrência de interrupções ao final da execução de cada instrução de máquina, tal como mostrado abaixo.
Como vocês podem ver existe também um mecanismo para temporariamente inibir o reconhecimento de interrupções pelo processsador. Isto é feito ligando/desligando bits de habilitação/desabilitação (enable/disable ou mask/unmask) em algum registrador de controle, um bit para cada tipo de interrupção suportada pelo processador. Quem faz uso disto? Tipicamente as rotinas do kernel, ou programas do usuário que invoquem funções ou serviços do sistema operacional que não possam ter sua execução interrompida.
Repare que a desabilitação (ou mascaramento) do reconhecimento de interrupções não elimina a sinalização da ocorrência da interrupção. Limpar a sinalização de interrupções pendentes são outros quinhentos, portanto quando a(s) interrupção(ões) voltarem a ser habilitadas o processador irá reconhecê-la(s).
Ao carregar no PC o endereço da primeira instrução do interrupt handler (contido no IV) temos o equivalente a um desvio incondicional do fluxo de execução para aquele endereço. As instruções de máquina do interrupt handler são executadas, então, da forma usual (podendo ou não, conforme o caso, ser interrompidas também). Cada rotina interrupt handler tem que, obrigatoriamente, como sua última atividade, restaurar o contexto que foi salvo. Isto restaura o valor do PC existente antes da interrupção, e força o retorno do fluxo de execução ao mesmo ponto do programa do usuário. A figura abaixo ilustra isso.
Claro que, além dos registradores, para que o programa do usuário possa retomar a execução normalmente as áreas de memória que contém as suas instruções de máquina e as suas estruturas de dados também tem que ser preservadas, mas isto é problema das funções de gerência da memória virtual do kernel, das quais falaremos em outro post.
Entendido o mecanismo de interrupção? Ótimo... passemos ao algoritmo time-sharing propriamente dito.
Um processo começa a sua vida quando algum usuário (via interface do usuário) ou programa do usuário (via system call) solicita a execução de um programa. A rotina do kernel invocada para esta função é chamada Loader, e faz o seguinte:
O Loader então passa o controle para outra rotina do kernel, chamada dispatcher, que:
A figura abaixo sintetiza todo este algoritmo.
Por enquanto chega. No próximo post desta série (e o último, até onde imaginei tratar deste assunto) vou tratar da gerência da memória virtual pelo kernel. Até lá...
A resposta é simples. Intercalando no tempo a execução dos vários programas do(s) usuário(s), e fazendo isto tão rápido que, para o observador humano, a aparência é de execução simultânea. Esta técnica é chamada de multitasking (multiprogramação), e o algoritmo mais popular para realizá-la é o time-sharing. Mas este algritmo necessita que o hardware (e/ou o microcódigo) implemente o mecanismo de interrupções (interrupts). Portanto vamos primeiro falar disso.
Interrupções:
Uma interrupção, como o nome indica, é um evento que provoca uma quebra na sequência normal do ciclo fetch-execute, através de um desvio incondicional para uma rotina de tratamento da interrupção (que tem de estar previamente carregada na memória, mas isto é papel do kernel durante a inicialização do sistema operacional) chamada interrupt handler.
A sinalização da interrupção pode ser gerada por algum elemento de hardware (ex.: o controlador de um dispositivo ao término de uma operação de I/O físico), ou pelo próprio programa em execução (este é o modo geral para invocar os serviços da API de system calls do sistema operacional). Cada tipo de interrupção suportado pelo processador possui um interrupt handler associado. Os endereços de memória correspondentes à primeira instrução de cada interrupt handler ficam armazenados em posições contíguas da memória, denominadas interrupt vector (IV).
Mas, para que este esquema possa funcionar, é necessário preservar o estado dos registradores do processador no momento da interrupção (em especial o program counter - PC), para que o programa que foi interrompido possa retornar a executar normalmente daquele ponto em diante. Isto é chamado de salvar o contexto do processo - que é o "apelido" para um programa executando sob o controle do kernel. Existem várias técnicas para salvar o contexto do processo. Por exemplo: usar uma estrutura de dados do kernel chamada stack (pelo que sei os processadores Intel desde o 8086 até o Pentium são assim), ou convencionar que cada rotina alvo de um desvio deve reservar memória e executar o salvamento do contexto da rotina de origem do desvio (como na programação assembly para mainframes IBM /370 e /370-XA. Creio que nas arquiteturas ESA/390 e z-Architecture ainda seja assim).
Ótimo. com todas estas peças no lugar, só precisamos agora mudar um pouquinho o nosso ciclo fetch-execute para incorporar a verificação da ocorrência de interrupções ao final da execução de cada instrução de máquina, tal como mostrado abaixo.
Como vocês podem ver existe também um mecanismo para temporariamente inibir o reconhecimento de interrupções pelo processsador. Isto é feito ligando/desligando bits de habilitação/desabilitação (enable/disable ou mask/unmask) em algum registrador de controle, um bit para cada tipo de interrupção suportada pelo processador. Quem faz uso disto? Tipicamente as rotinas do kernel, ou programas do usuário que invoquem funções ou serviços do sistema operacional que não possam ter sua execução interrompida.
Repare que a desabilitação (ou mascaramento) do reconhecimento de interrupções não elimina a sinalização da ocorrência da interrupção. Limpar a sinalização de interrupções pendentes são outros quinhentos, portanto quando a(s) interrupção(ões) voltarem a ser habilitadas o processador irá reconhecê-la(s).
Ao carregar no PC o endereço da primeira instrução do interrupt handler (contido no IV) temos o equivalente a um desvio incondicional do fluxo de execução para aquele endereço. As instruções de máquina do interrupt handler são executadas, então, da forma usual (podendo ou não, conforme o caso, ser interrompidas também). Cada rotina interrupt handler tem que, obrigatoriamente, como sua última atividade, restaurar o contexto que foi salvo. Isto restaura o valor do PC existente antes da interrupção, e força o retorno do fluxo de execução ao mesmo ponto do programa do usuário. A figura abaixo ilustra isso.
Claro que, além dos registradores, para que o programa do usuário possa retomar a execução normalmente as áreas de memória que contém as suas instruções de máquina e as suas estruturas de dados também tem que ser preservadas, mas isto é problema das funções de gerência da memória virtual do kernel, das quais falaremos em outro post.
Entendido o mecanismo de interrupção? Ótimo... passemos ao algoritmo time-sharing propriamente dito.
Time-sharing
Um processo começa a sua vida quando algum usuário (via interface do usuário) ou programa do usuário (via system call) solicita a execução de um programa. A rotina do kernel invocada para esta função é chamada Loader, e faz o seguinte:
- Invoca as rotinas de gerência da memória virtual para alocar os blocos de memória necessários para acomodar as instruções de máquina e as estruturas de dados do programa solicitado;
- Cria as estruturas de dados para o controle do processo pelo kernel;
- Cria uma entrada para o novo processo na ready queue (fila de processos prontos para execução).
O Loader então passa o controle para outra rotina do kernel, chamada dispatcher, que:
- Seleciona o primeiro processo na ready queue;
- Remove o processo selecionado e reorganiza a ready queue (faz a fila andar um passo à frente);
- Calcula, com base na estatística dos períodos anteriores de execução do processo selecionado (se houver, senão é feita uma estimativa inicial) o tempo máximo que este processo receberá do processador. Este intervalo de tempo é chamado time slice do processo, e é sempre um múltiplo inteiro de um intervalo básico denominado quantum (que normalmente depende do modelo do processador utilizado);
- Programa o relógio (clock) do processador para provocar uma interrupção após transcorrido o tempo de duração do time slice calculado;
- Restaura o contexto do processo selecionado.
- O time slice acabe (o que é sinalizado pela clock interrupt programada pelo Dispatcher);
- O programa ceda voluntariamente o controle do processador. Normalmente isto ocorre como parte do processamento de alguma system call invocada pelo programa, cujo completamento será demorado (ex.: solicitação de operações de I/O);
- Término (normal ou anormal) da execução do programa.
- Se processo perdeu o controle do processador por término (caso 3), então invoca as rotinas de gerência da memória virtual para liberar as áreas de memória associadas ao processo e apaga as esturutras de dados para controle do processo;
- Se o proocesso perdeu o controle do processador por cessão voluntária (caso 2), então verifica se existem pendências para o processo (ex.: o completamento de operação de I/O). Se existirem pendências o processo é colocado na wait queue (fila de espera), senão o processo é colocado de volta na ready queue;
- Se o processo perdeu o controle do processador por término do time slice (caso 1) então o processo é colocado de volta na ready queue.
- Verifica se existem processos na wait queue cujas pendências já tenham sido liberadas (isto ocorre como parte do processamento de outros tipos de interrupção, como I/O interrupts, por exemplo). Os processos que não possuam mais pendências são, então, promovidos para a ready queue.
A figura abaixo sintetiza todo este algoritmo.
Por enquanto chega. No próximo post desta série (e o último, até onde imaginei tratar deste assunto) vou tratar da gerência da memória virtual pelo kernel. Até lá...
domingo, 27 de março de 2011
Disponibilidade (1)
Outro dia vi algumas mensagens, em um dos vários grupos de discussão via e-mail que acompanho, dizendo algumas inconsistências sobre o tema disponibilidade. Então vou, modestamente, apresentar os conceitos básicos dasta área.
Em um instante t qualquer um componente ou sistema pode estar em um entre dois estados:
E a questão básica do projeto do componente ou sistema é determinar que características ele deve possuir para satisfazer à condição que, no instante t = T (arbitrário) ocorra que:
onde p é o valor de disponibilidade especificado nos requisitos funcionais do componente ou sistema. Estes requisitos são, muitas vezes, especificados em termos de "número de noves", conforme a tabela abaixo.
As colunas de downtime máximo foram calculadas considerando o valor máximo para o tempo de indisponibilidade (downtime) para atingir o valor de disponibilidade especificado dentro do respectivo horizonte de tempo (o mês foi considerado como sendo de 30 dias).
Temos então mais uma relação fundamental para o cálculo de indisponibilidade. Chamando Ta ao somatório da duração de todos os intervalos de tempo obsrvados para os quais X(t) = 1, e Tu ao somatório da duração de todos os intervalos de tempo observados para os quais X(t) = 0, então a disponibilidade A é dada pela expressão:
Na maioria dos casos os componentes ou sistemas que usamos nos nossos projetos são fornecidos por terceiros. Como saber qual a disponibilidade esperada para eles? Quando o fornecedor indica explícitamente a disponibilidade esperada como uma probabilidade específica ou - o que é mais comum - indicando em qual categoria de "número de noves" o seu produto se encaixa a coisa é mais simples.
Entretanto o mais comum é ser indicado apenas o tempo médio esperado entre duas falhas consecutivas do omponente ou do sistema (mean time between failures - MTBF). Sendo assim, para podermos usar a expressão acima é necessário encontrar qual o valor médio do tempo de reparo esperado para uma falha qualquer (mean time to repair - MTTR). Com estes dois valores temos que:
Observe que o valor do MTBF é determinado pelo fornecedor, mas o valor do MTTR depende totalmente do processo de manutenção onde aquele componente ou sistema estiver inserido. Considere, por exemplo, a tabela abaixo:
Isto mostra que, se queremos realizar projetos de alta disponibilidade, é necessário dar muita atenção ao desenho dos processos de manutenção (em garantia, fora de garantia, com pessoal próprio ou terceirizado, estoque se peças de reposição no local ou não, lights-out operation, etc.).
Até agora viemos falando sobre a disponibilidade de sistemas como um todo, mas como é possível calcular a disponibilidade global de sistemas com vários componentes, supondo conhecidas as disponibilidades esperadas para os componentes individuais? A premissa básica para a resposta que vamos dar para esta pergunta é: as probabilidades de falha dos componentes do sistema são independentes entre si. Se isto não for verdade então é necessário introduzir probabilidades condicionais nos cálculos (o que não vou fazer aqui).
Lembrando que se dois eventos A e B são independentes então:
Sabemos que a disponibilidade esperada para um elemento é a probabilidade que ele funcione a contento quando necessário. Então a probabilidade P(X(T) = 0) que um elemento falhe será dada por:
Se tivermos um sistema formado por dois componentes em série, conforma a figura abaixo:
Este sistema falhará se um ou outro ou ambos os componentes falharem. Colocando isto em termos de probabilidades temos:
Se tivermos um sistema formado por dois componentes em paralelo, conforma a figura abaixo:
Este sistema falhará se ambos os componentes falharem. Então as probabilidades são:
Isto cobre o feijão com arroz do assunto. Sinceramente eu não sei muito bem porque os teóricos desta área ainda insistem nestas expressões para a disponibilidade do todo em função da disponibilidade das partes. Para mim parece muito mais simples trabalhar diretamente com os valores de probabilidade de falha dos componentes para obter a probabilidade de falha do todo, e transformar isto para disponibilidade no final. No próximo (e último) artigo sobre este assunto vamos ver um algoritmo para avaliar a disponibilidade de um sistema complexo.
Em um instante t qualquer um componente ou sistema pode estar em um entre dois estados:
- Disponível (available) - ele é capaz de desempenhar suas funções coforme especificado;
- Indisponível (unavailable) - ele não é capaz de desempenhar suas funções coforme especificado;
E a questão básica do projeto do componente ou sistema é determinar que características ele deve possuir para satisfazer à condição que, no instante t = T (arbitrário) ocorra que:
onde p é o valor de disponibilidade especificado nos requisitos funcionais do componente ou sistema. Estes requisitos são, muitas vezes, especificados em termos de "número de noves", conforme a tabela abaixo.
As colunas de downtime máximo foram calculadas considerando o valor máximo para o tempo de indisponibilidade (downtime) para atingir o valor de disponibilidade especificado dentro do respectivo horizonte de tempo (o mês foi considerado como sendo de 30 dias).
Temos então mais uma relação fundamental para o cálculo de indisponibilidade. Chamando Ta ao somatório da duração de todos os intervalos de tempo obsrvados para os quais X(t) = 1, e Tu ao somatório da duração de todos os intervalos de tempo observados para os quais X(t) = 0, então a disponibilidade A é dada pela expressão:
Na maioria dos casos os componentes ou sistemas que usamos nos nossos projetos são fornecidos por terceiros. Como saber qual a disponibilidade esperada para eles? Quando o fornecedor indica explícitamente a disponibilidade esperada como uma probabilidade específica ou - o que é mais comum - indicando em qual categoria de "número de noves" o seu produto se encaixa a coisa é mais simples.
Entretanto o mais comum é ser indicado apenas o tempo médio esperado entre duas falhas consecutivas do omponente ou do sistema (mean time between failures - MTBF). Sendo assim, para podermos usar a expressão acima é necessário encontrar qual o valor médio do tempo de reparo esperado para uma falha qualquer (mean time to repair - MTTR). Com estes dois valores temos que:
Observe que o valor do MTBF é determinado pelo fornecedor, mas o valor do MTTR depende totalmente do processo de manutenção onde aquele componente ou sistema estiver inserido. Considere, por exemplo, a tabela abaixo:
Isto mostra que, se queremos realizar projetos de alta disponibilidade, é necessário dar muita atenção ao desenho dos processos de manutenção (em garantia, fora de garantia, com pessoal próprio ou terceirizado, estoque se peças de reposição no local ou não, lights-out operation, etc.).
Até agora viemos falando sobre a disponibilidade de sistemas como um todo, mas como é possível calcular a disponibilidade global de sistemas com vários componentes, supondo conhecidas as disponibilidades esperadas para os componentes individuais? A premissa básica para a resposta que vamos dar para esta pergunta é: as probabilidades de falha dos componentes do sistema são independentes entre si. Se isto não for verdade então é necessário introduzir probabilidades condicionais nos cálculos (o que não vou fazer aqui).
Lembrando que se dois eventos A e B são independentes então:
Sabemos que a disponibilidade esperada para um elemento é a probabilidade que ele funcione a contento quando necessário. Então a probabilidade P(X(T) = 0) que um elemento falhe será dada por:
Se tivermos um sistema formado por dois componentes em série, conforma a figura abaixo:
Este sistema falhará se um ou outro ou ambos os componentes falharem. Colocando isto em termos de probabilidades temos:
Se tivermos um sistema formado por dois componentes em paralelo, conforma a figura abaixo:
Este sistema falhará se ambos os componentes falharem. Então as probabilidades são:
Isto cobre o feijão com arroz do assunto. Sinceramente eu não sei muito bem porque os teóricos desta área ainda insistem nestas expressões para a disponibilidade do todo em função da disponibilidade das partes. Para mim parece muito mais simples trabalhar diretamente com os valores de probabilidade de falha dos componentes para obter a probabilidade de falha do todo, e transformar isto para disponibilidade no final. No próximo (e último) artigo sobre este assunto vamos ver um algoritmo para avaliar a disponibilidade de um sistema complexo.
terça-feira, 22 de março de 2011
Sistemas de Computação 7 - Programação e sistemas operacionais
Até agora a única forma que vimos para programar uma máquina Von Neumann é codificar a sequência de instruções de máquina (em binário) em algum meio legível pela máquina (ex.: fitas de papel perfuradas ou cartões perfurados).
A execução do programa ocorre em duas fases: primeiro colocava-se a máquina em modo de carga de programa (program load) e executava-se a leitura das instruções de máquina para o local apropriado da memória; depois carregava-se o endereço da primeira instrução do programa no registrador PC (program counter) e mandava-se iniciar o ciclo fetch-execute a partir daí (program run). Após o término da execução do programa todo o processo tinha que ser repetido para a execução do próximo programa.
Estes dois processos (programação e execução) eram complicados e muito suscetíveis a erros. A solução foi dar um passo de abstração à frente. Na área da programação isto foi feito com o surgimento das primeiras linguagens Assembly, e na execução surgiram os primeiros sistemas operacionais.
A grande novidade das linguagns Assembly (ou linguagens de segunda geração - sendo as linguagens de máquina a primeira geração) foi permitir que os programadores fizessem uso de referências simbólicas e mnemônicas aos elementos do programa (instruções e operandos). Vejamos um exemplo simples (ver IBM z/Architecture Principles of Operation). Suponhamos que o programador deseje executar a seguinte sequência de operações
A execução do programa ocorre em duas fases: primeiro colocava-se a máquina em modo de carga de programa (program load) e executava-se a leitura das instruções de máquina para o local apropriado da memória; depois carregava-se o endereço da primeira instrução do programa no registrador PC (program counter) e mandava-se iniciar o ciclo fetch-execute a partir daí (program run). Após o término da execução do programa todo o processo tinha que ser repetido para a execução do próximo programa.
Estes dois processos (programação e execução) eram complicados e muito suscetíveis a erros. A solução foi dar um passo de abstração à frente. Na área da programação isto foi feito com o surgimento das primeiras linguagens Assembly, e na execução surgiram os primeiros sistemas operacionais.
Linguagens Assembly
A grande novidade das linguagns Assembly (ou linguagens de segunda geração - sendo as linguagens de máquina a primeira geração) foi permitir que os programadores fizessem uso de referências simbólicas e mnemônicas aos elementos do programa (instruções e operandos). Vejamos um exemplo simples (ver IBM z/Architecture Principles of Operation). Suponhamos que o programador deseje executar a seguinte sequência de operações
- Carregar no registrador de propósito geral número 2 os 32 bits (4 bytes) localizados a partir do endereço contido no registrador de propósito geral número 12;
- Crregar no registrador de propósito geral número 3 os 32 bits localizados a partir do endereço contido no registrador de propósito geral número 12 mais 32 bits;
- Somar os conteúdos dos registradores de propósito geral números 2 e 3 (considerados como números inteiros representados em formato binário com sinal);
- Armazenar o resultado da soma nos 32 bits localizados a partir do endereço contido no registrador de propósito geral número 12 mais 64 bits.
5820C0005830C0041A235020C008
A mesma sequência de quatro instruções na linguagem Assembly desta arquitetura poderiam ser codificadas da seguinte forma:
L R2,0(R0,R12) R2=addr(R12)
L R3,4(R0,R12) R3=addr(R12)+4
AR R2,R3 R2=R2+R3
ST R2,8(R0,R12) addr(R12+8)=R2
Bem melhor. Mas ainda dá pra melhorar. Se o programador adotar nomes simbólicos para as localizações de memória apontadas a partir do endereço contido no registrador de propósito geral 12 (usando instruções Assembly do tipo define storage - mnemônico DS) a sequência de instruções poderia ser da seguinte forma:
USING *,R12 R12=baseaddr
...
PARCELA1 DS F 4 bytes
PARCELA2 DS F 4 bytes
SOMA DS F 4 bytes
...
L R2,PARCELA1 R2=PARCELA1
L R3,PARCELA2 R3=PARCELA2
AR R2,R3 R2=R2+R3
ST R2,SOMA SOMA=R2
Ótimo, só que este avanço não vem de graça. Para gerar a sequência de instruções de máquina correspondente às instruções simbólicas Assembly é necessário um programa de tradução denominado Assembler. O programa escrito pelo programador usando instruções Assembly é denominado programa fonte, que é utilizado como entrada pelo programa Assembler, gerando como saída o programa equivalente em linguagem de máquina, denominado programa objeto.
A prática mostrou que quase todos os programas possuiam seções de código virtualmente idênticas (ex.: rotinas para executar operações de entrada/saída de dados). Além disso, programas comumente compartilhavam descrições de estruturas de dados. A partir destes fatos introduziu-se na linguagem Assembly a possibilidade de incorporar trechos do programa fonte a partir de bibliotecas de código fonte, bem como incorporar sequências já traduzidas de código objeto como parte do programa. Assim o processo de construção de um programa executável passou a ser um processo de duas etapas, como mostrado na figura abaixo.
Este modelo geral para a criação dos programas executáveis persiste até hoje. A única diferença é que o programa fonte agora é escrito em outras linguagens, mais abstratas (chamadas de terceira geração), e o programa responsável pela tradução do programa fonte para o programa objeto é chamado compilador.
Os compiladores, a propósito, tornaram-se uma forma muito conveniente para garantir que os programas executáveis utilizassem adequadamente os serviços de um novo elemento que surgiu nesta época: o sistema operacional.
A primeira motivação para a existência de programas especializados em supervisionar o ambiente de execução dos programas foi a criação da abstração de arquivos, que dá aos programadores primitivas padronizadas para executar operações de entrada e saída de dados (ex.: ler/gravar em fita magnética; imprimir; etc.). Em termos modernos chamaríamos isto de uma API (application programming interface).
Logo também foi notado que o modelo de execução de um programa de cada vez era altamente ineficiente (a diferença entre o tempo de execução de instruções pelo processador e o tempo para execução de operações de entrada/saída de dados cria grandes "buracos" de inatividade do processador). A solução para isto foi criar uma nova camada de abstração entre os programas e a máquina, permitindo que o tempo do processador e a memória pudessem ser compartilhados, criando para cada programa a ilusão de possuir o controle exclusivo da máquina;
Com isso passamos a ter duas "classes" programas em execução: os programas de controle, ou de supervisão, responsáveis pela administração do ambiente virtual de execução; e os programas de aplicação, voltados para a solução dos problemas dos usuários e que executam "encaixotados" no ambiente virtual de execução administrado pelos programas de sistema. Os programas de controle formam o núcleo (kernel) do sistema operacional, e fornecem aos programas de aplicação uma API comumente conhecida como chamadas de sistema (system calls), que inclui a API de arquivos e outras funções básicas (ex.: solicitar execução de programa).
Cada programa em execução gerenciado pelos programas de controle (incluindo aí as estruturas de dados que descrevem o estado do programa de aplicação para os programas de controle) é chamado um processo. desta forma o modelo operacional da máquina, do kernel do sistema operacional e dos processos é como mostrado na figura abaixo.
Nos próximos artigos desta série vamos examinar mais de perto como o kernel executa as funções de compartilhamento do tempo do processador e da memória. Até breve.
A prática mostrou que quase todos os programas possuiam seções de código virtualmente idênticas (ex.: rotinas para executar operações de entrada/saída de dados). Além disso, programas comumente compartilhavam descrições de estruturas de dados. A partir destes fatos introduziu-se na linguagem Assembly a possibilidade de incorporar trechos do programa fonte a partir de bibliotecas de código fonte, bem como incorporar sequências já traduzidas de código objeto como parte do programa. Assim o processo de construção de um programa executável passou a ser um processo de duas etapas, como mostrado na figura abaixo.
Este modelo geral para a criação dos programas executáveis persiste até hoje. A única diferença é que o programa fonte agora é escrito em outras linguagens, mais abstratas (chamadas de terceira geração), e o programa responsável pela tradução do programa fonte para o programa objeto é chamado compilador.
Os compiladores, a propósito, tornaram-se uma forma muito conveniente para garantir que os programas executáveis utilizassem adequadamente os serviços de um novo elemento que surgiu nesta época: o sistema operacional.
Sistemas Operacionais
A primeira motivação para a existência de programas especializados em supervisionar o ambiente de execução dos programas foi a criação da abstração de arquivos, que dá aos programadores primitivas padronizadas para executar operações de entrada e saída de dados (ex.: ler/gravar em fita magnética; imprimir; etc.). Em termos modernos chamaríamos isto de uma API (application programming interface).
Logo também foi notado que o modelo de execução de um programa de cada vez era altamente ineficiente (a diferença entre o tempo de execução de instruções pelo processador e o tempo para execução de operações de entrada/saída de dados cria grandes "buracos" de inatividade do processador). A solução para isto foi criar uma nova camada de abstração entre os programas e a máquina, permitindo que o tempo do processador e a memória pudessem ser compartilhados, criando para cada programa a ilusão de possuir o controle exclusivo da máquina;
Com isso passamos a ter duas "classes" programas em execução: os programas de controle, ou de supervisão, responsáveis pela administração do ambiente virtual de execução; e os programas de aplicação, voltados para a solução dos problemas dos usuários e que executam "encaixotados" no ambiente virtual de execução administrado pelos programas de sistema. Os programas de controle formam o núcleo (kernel) do sistema operacional, e fornecem aos programas de aplicação uma API comumente conhecida como chamadas de sistema (system calls), que inclui a API de arquivos e outras funções básicas (ex.: solicitar execução de programa).
Cada programa em execução gerenciado pelos programas de controle (incluindo aí as estruturas de dados que descrevem o estado do programa de aplicação para os programas de controle) é chamado um processo. desta forma o modelo operacional da máquina, do kernel do sistema operacional e dos processos é como mostrado na figura abaixo.
Nos próximos artigos desta série vamos examinar mais de perto como o kernel executa as funções de compartilhamento do tempo do processador e da memória. Até breve.
Assinar:
Postagens (Atom)